Nova Project
Od lat mówimy komputerom, co mają robić. Od niedawna odpowiadają.
Zwykle uprzejmie i z wielką pewnością siebie. Nie zawsze do rzeczy. Nad tym pracujemy.
Do rzeczy
Sprawiamy, że otwarte modele działają na sprzęcie, który masz, z danymi, których nie chcesz nikomu wysyłać.
- 01
Modele językowe na własnym sprzęcie
Uruchamiamy otwarte modele tam, gdzie leżą dane: na Apple Silicon i kartach NVIDIA. Dobieramy model, kwantyzację i budżet pamięci do konkretnej maszyny, a potem mierzymy, co z tego wyszło.
- 02
Własny silnik inferencji
Piszemy go w Ruście, od jąder GPU po serwer HTTP, bez Pythona w ścieżce żądania. Nowe architektury przenosimy warstwa po warstwie i sprawdzamy, czy liczą to samo co referencja. Ostatnio była to hybryda Mamby i attention w Nemotron-H.
- 03
Modele w aplikacjach i urządzeniach
Modele widzenia komputerowego wbudowujemy w produkty: jeden natywny silnik w Ruście, ONNX Runtime i stabilne API dla aplikacji na Apple i Windows, bez ciągnięcia za sobą Pythona i OpenCV.
- 04
Systemy wokół modeli
Sam model niewiele załatwia. Dokładamy wyszukiwanie, reranking, wywołania narzędzi, odpowiedzi w schemacie JSON i ocenę na prawdziwych pytaniach, zamiast wierzyć w ranking z internetu.
MiRMiRTwoje modele. Twoja maszyna.
Natywne środowisko do uruchamiania modeli językowych: Apple Silicon (Metal) i karty NVIDIA (CUDA). Jeden program w Ruście, z panelem w terminalu, panelem w przeglądarce i serwerem zgodnym z API OpenAI, z wywołaniami narzędzi i odpowiedziami w schemacie JSON.
$ cargo install mirmir
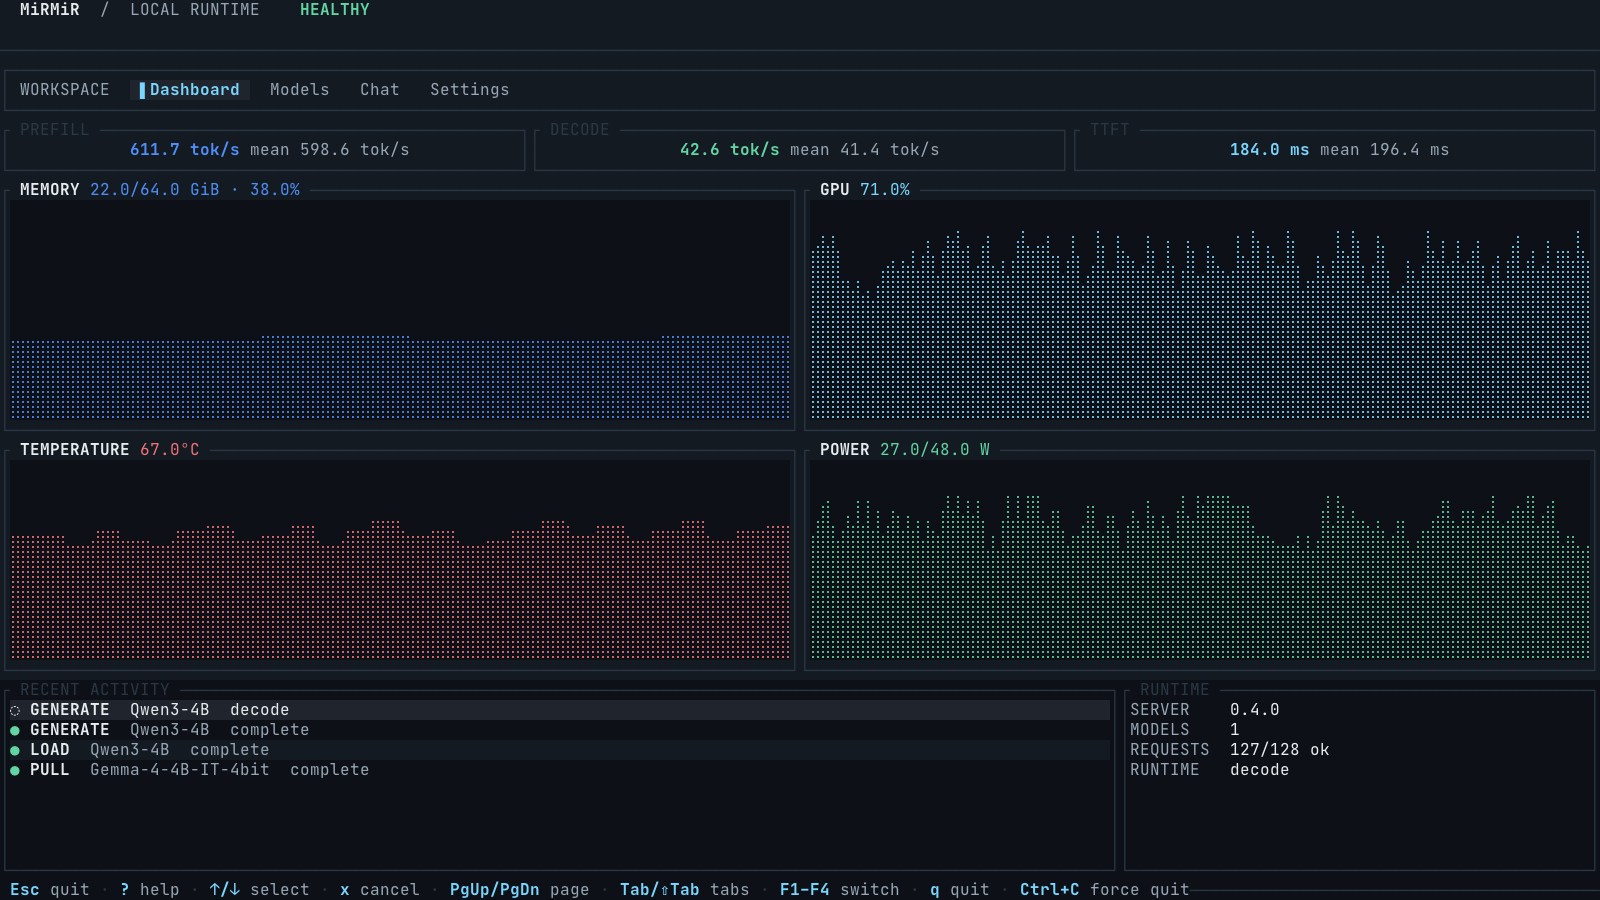
Przepustowość względem silników referencyjnych
Wiersze poniżej 100% też zostają na stronie.
- Przetwarzanie promptu
- Dekodowanie
- 100% = silnik referencyjny
| Model | Względem referencji 100%150%200% | Przetwarzanie promptu | Dekodowanie |
|---|---|---|---|
| GPT-OSS-20B BF16GB10 · vLLM 0.29.0 | 199,6% | 188,0% | |
| Qwen3.8-27B BF16GB10 · vLLM 0.29.0 | 117,0% | 100,3% | |
| Qwen3.6-35B-A3B NVFP4GB10 · vLLM 0.29.0 | 102,6% | 95,4% | |
| Qwen3-4B BF16GB10 · vLLM 0.29.0 | 94,9% | 103,9% | |
| Qwen3-4B BF16M3 Max · MLX-LM | 91,8% | 80,8% |
Projekty
Nie wszystko, co robimy, odpowiada pełnymi zdaniami.
-
Analiza skóry
Dermatoskop od oprogramowania urządzenia po aplikacje na Apple, Windows i Androida. Modele oceniają zmarszczki, pory, naczynia, przebarwienia, strukturę, sebum i keratynę, a całość liczy jeden natywny silnik w Ruście.
-
Edward
Platforma dla klinik: rejestracja, terminarz, konsultacje, pobyt dzienny, dokumentacja medyczna, podpis elektroniczny, portal pacjenta i raportowanie do P1, z audytem operacji i udostępnień.
-
Od neuronu do biliona dolarów
Historia i ekonomia sztucznej inteligencji: dwanaście rozdziałów, bez matematyki, z rachunkiem na końcu każdego z nich. Wstęp i pierwszy rozdział są za darmo.
-
faststep
Framework UI dla embedded Rusta inspirowany UIKitem. Aplikacja opisuje widoki i zachowanie, a dotyk, przewijanie i odświeżanie załatwia framework.
A poza tym: usługa podpisu dokumentów w Ruście, aplikacja dla serwisantów z pracą offline i integracją z obiegiem zleceń.